AI 让内容生产变快了,但“发得多”不等于“有人看”。搜索引擎要先抓到页面、理解页面,才可能把它放进结果页;生成式引擎要先找到可核验的段落,才可能在回答里引用它。
对 AI 创作者来说,SEO 和 GEO 不是两套额外工作,而是同一次内容工程:让页面可被抓取、可被理解、可被验证,最后才可能被引用。下面这份清单按这个顺序展开,适合发布前逐项检查。
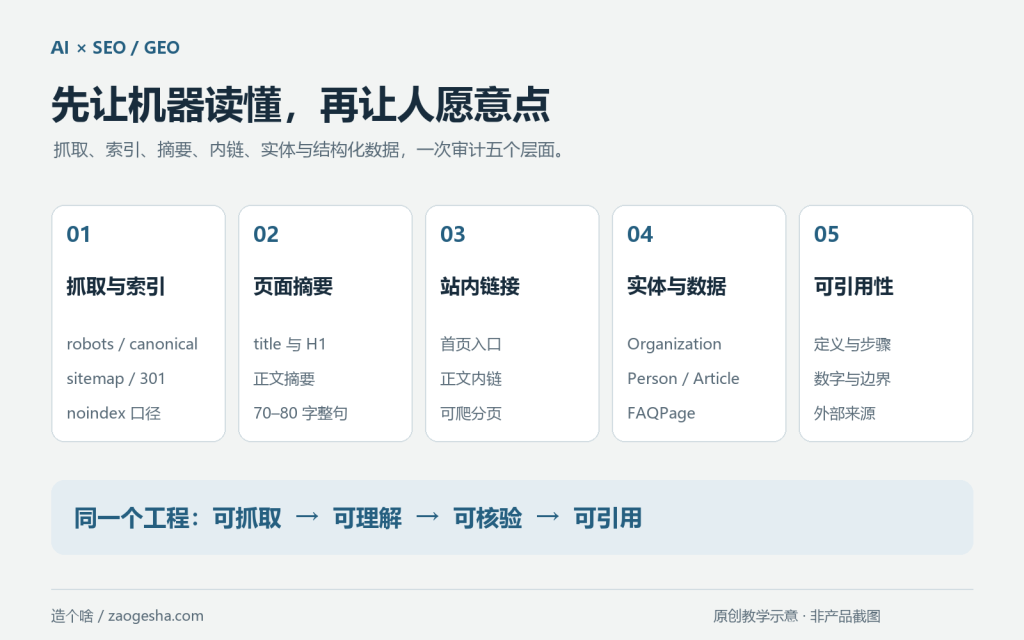
SEO 和 GEO 的共同底座
SEO 关心页面能否被搜索引擎收录并在结果页展示;GEO 关心生成式引擎在回答问题时,是否会检索、理解并引用你的内容。两者的底层条件高度重叠:
- 页面不登录也能返回完整正文;
- 标题和摘要准确描述页面;
- 作者、日期、来源和实体关系清楚;
- 内容里有定义、步骤、数字和边界,而不是只有结论;
- 站内链接能把同一主题的内容连起来。
如果页面连“被机器读懂”都做不到,关键词和 AI 优化都只是表面工作。
一、先让页面能被抓到
发布前先确认最基本的三件事:
- 地址唯一:
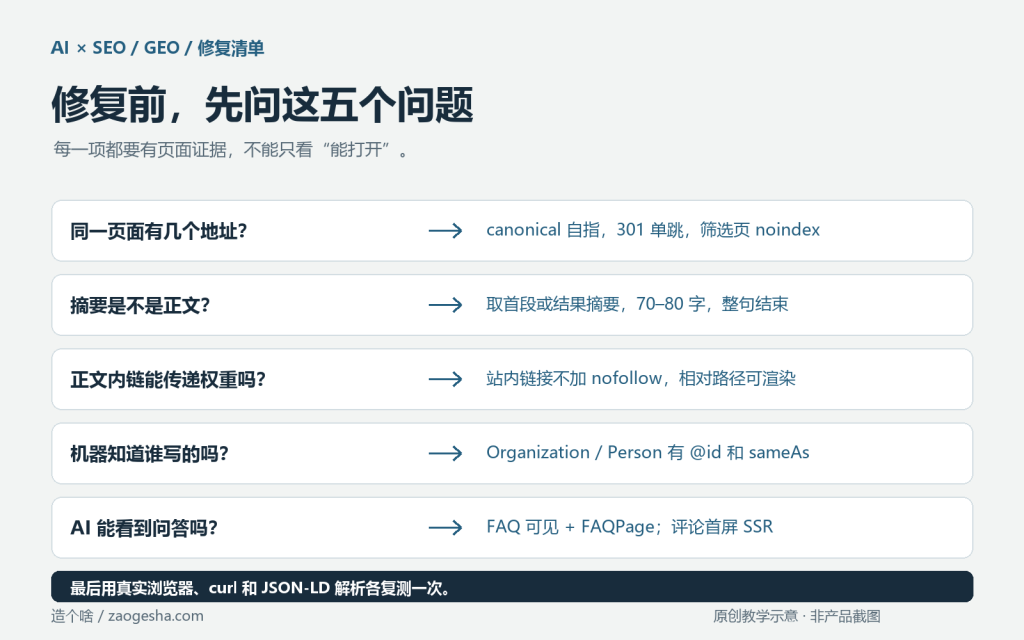
http、非www、无尾斜杠和带跟踪参数的地址,都应该 301 到规范地址。 - 索引策略明确:文章、作者页、主题页允许收录;搜索页、账户页、筛选组合页按需 noindex。
- sitemap 只放可索引内容:空栏目、越界分页和重复参数页不要提交。
如果站点使用无限滚动,列表页最好保留一个可爬的分页兜底。只靠 JavaScript 加载的内容,爬虫和没有脚本的环境都可能看不到。
二、标题和摘要要回答具体问题
标题不是口号,而是读者在结果页看到的第一句承诺。一个可用的标题通常包含“对象 + 问题/结果”,例如“AI 压缩图片怎么选格式”,而不是“让创作更高效”。
摘要要说明这一页具体讲什么:
- 优先取正文首段或作者填写的摘要,不要回退到全站介绍;
- 中文控制在 70–80 字,尽量以完整句子结束;
- 不要在逗号处截断,也不要把标题原样重复一遍;
- 摘要、
og:description和结构化数据里的描述保持一致。
三、正文结构:定义、步骤、边界、证据
AI 生成的内容很容易“看起来完整”,但缺少可核验的细节。发布前可以用四个问题检查:
- 有没有一句话定义核心概念?
- 有没有可照着做的步骤,而不只是结论?
- 有没有说明适用范围、失败条件或不适用场景?
- 关键数字、方法或结论有没有来源?
一篇文章不需要覆盖所有情况,但读者和 AI 引擎都需要知道“什么条件下成立”。把边界写清楚,比多写三段泛泛而谈更有价值。
四、让作者和站点成为可识别实体
搜索引擎和生成式引擎不只看单篇内容,还会判断“谁写的、这个站点是否可信”。至少把三类信息写清楚:
- 站点:名称、定位、网址、logo、联系方式;关于页和联系页不要只有一句介绍。
- 作者:公开昵称、简介、头像、擅长的领域;有真实主页或公开资料时再填
sameAs链接。 - 文章:作者、发布时间、修改时间、所属主题和许可。
作者信息不需要暴露隐私。只使用你愿意公开的昵称和简介,不要把邮箱、登录名或后台地址写进结构化数据。
五、结构化数据只写页面看得到的东西
结构化数据是“把页面内容翻译成机器可读格式”,不是另一套内容。常见的最小组合是:
Organization:站点实体,全站共用一个@id;WebSite:站点名称、网址和搜索入口;Article:标题、摘要、作者、时间、主题、语言和许可;FAQPage:页面上真实可见的问答;BreadcrumbList:与可见面包屑一致的层级路径。
如果页面没有 FAQ 区块,就不要输出 FAQPage;如果作者页没有公开简介,就不要编造资质。结构化数据和页面内容不一致,短期可能骗过检查工具,长期会失去信任。
六、用内链把内容连成主题
单篇文章很难建立主题权威。更有效的做法是围绕一个问题写一组内容,再用内链把它们连起来:
- 首页或主题 hub 给出最新、最相关的入口;
- 每篇文章链到同一主题下的前置概念、后续步骤和反面案例;
- 站内链接用普通
<a>,不要加nofollow; - 链接文字要说明目标内容,不要用“点击这里”。
当一组页面互相解释、互相补充时,搜索引擎更容易判断站点在某个主题上的覆盖深度,AI 引擎也更容易找到上下文。
七、图片、评论与无 JS 可读性
正文图片建议使用公开可缓存地址,并提供 srcset 和宽高,避免布局跳动;首图可以设高优先级,其余图片懒加载。图片的 alt 要描述内容,而不是堆关键词。
评论区如果只靠 XHR 加载,爬虫和没有 JavaScript 的读者只能看到“正在加载”。把第一页评论服务端渲染出来,既改善可读性,也让讨论内容成为页面文本的一部分。后续分页再交给接口。
八、发布后怎么验证
不要只用“页面能打开”判断发布成功。建议分三层检查:
- 页面层:真实浏览器检查标题、摘要、H1、正文、图片和评论是否在首屏 HTML;
- 协议层:用
curl检查状态码、canonical、robots、sitemap、RSS 和图片缓存头; - 数据层:解析 JSON-LD,确认实体、文章和 FAQ 字段与页面可见内容一致。
发布后观察索引、展现和查询词需要时间。不要因为一天内没有变化就频繁改标题;先确认技术项没有回归,再根据真实数据迭代内容。
常见问题
AI 生成的内容会被搜索引擎惩罚吗?
不会因为“由 AI 生成”本身被惩罚。真正影响收录和排名的是内容是否原创、准确、对读者有用,以及是否经过事实核查。批量生成低质页面、虚构来源或堆砌关键词,才是风险所在。
小站点也需要做结构化数据吗?
需要,但不必追求复杂。至少把站点、文章和作者三类信息写对,字段与页面可见内容一致;没有真实问答就不要输出 FAQ 结构化数据。
SEO 和 GEO 的优先级怎么排?
先做抓取、索引、标题和正文结构,再做实体、结构化数据和内链。前者决定页面能不能被看到,后者决定页面值不值得被引用;顺序反过来,通常事倍功半。
参考资料
- Google Search Essentials:抓取、索引和排名的基础要求。
- Google:Creating helpful, reliable, people-first content:内容质量与 E-E-A-T 的官方说明。
- schema.org Article 与 FAQPage:文章和问答结构化数据字段。
- web.dev:Cumulative Layout Shift:图片尺寸与布局稳定性。
- llms.txt 提案:面向 AI 检索的站点说明文件格式。
社区讨论 0 条观点