AI 写的代码怎么上线?用构建号、清单和回滚把发布做成可复现
用 AI 写代码,最危险的时刻往往不是生成代码,而是“它好像能跑,那就发上去吧”。
生成得快,改动就多;改动一多,“这次能跑”就变成一句只对当下负责的话。过几天再发一次,没人说得清线上到底是哪一版、和仓库里的提交差多少、出问题能不能退回去。
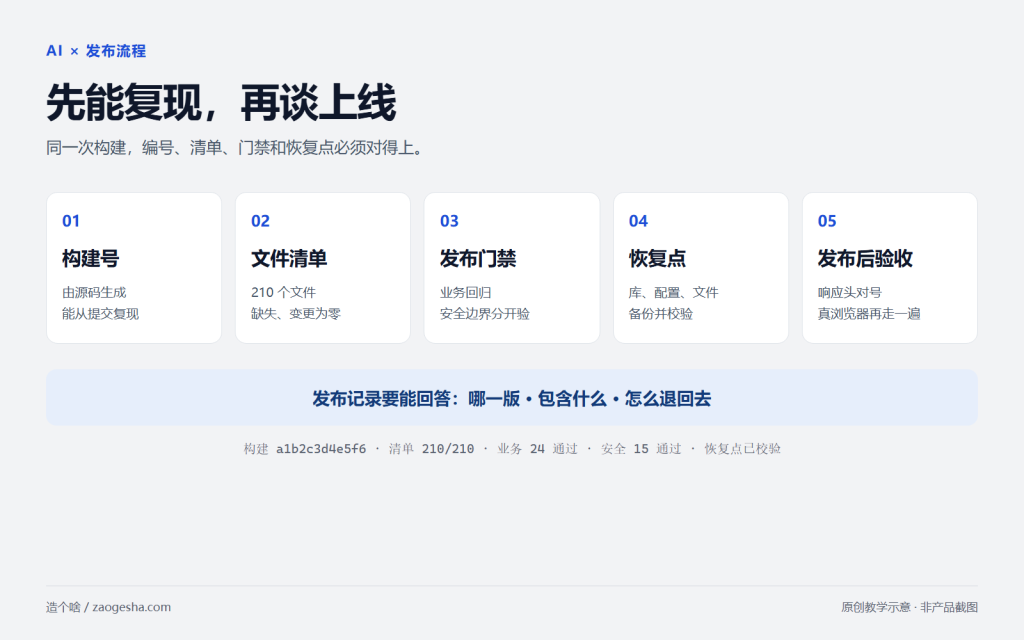
本文把一次发布拆成五个可检查的环节:构建号、文件清单、发布门禁、恢复点、发布后验收。它们不依赖某个具体工具,小项目也能照做。文中示例均为虚构,用来演示记录方式,不代表真实项目数据。

一、“这次能跑”和“可复现”差在哪
“这次能跑”描述的是某台机器、某次操作的结果:你在本机构建,点了几下,页面正常。它没有回答三个问题:
- 线上运行的文件,和仓库里的哪次提交对应?
- 换一台机器、换一个人,能不能得到同一份构建?
- 发布失败或上线后出问题,多久能恢复到发布前的状态?
可复现的发布,要求这三个问题都有明确答案。答案不是“我记得”,而是能被别人复核的记录。
二、构建号从源码生成,不要手工起名
很多项目的版本号是手填的:v2、final、final-2。这类名字无法回答“线上是哪一版”,因为同一个名字可以对应多次不同的构建。
更稳妥的做法,是让构建号由源码内容计算出来。一个简单做法是:对参与运行的文件逐个取哈希,再把路径和哈希按固定顺序拼起来取总哈希,截取前 12 位作为构建号。构建过程把编号写进产物,页面响应头也带上它。
这样带来两个直接好处:
- 构建号相同,说明运行文件相同;构建号不同,说明至少有一个文件变了。
- 发布后只要看一眼响应头,就能确认线上版本,而不是靠登录后台翻记录。
这里有一个容易忽略的细节:换行符也算文件内容。同一个提交,在 Windows 工作区被写成 CRLF、在另一台机器上检出为 LF,源码哈希就会不同,构建号也跟着变。看起来“什么都没改”,构建号却变了。
解决办法不是记住哪台机器用哪种换行,而是让仓库统一换行规则(例如在 .gitattributes 里声明文本文件使用 LF),并从干净检出重新构建。构建号要能从提交稳定复现,才有资格作为发布依据。
三、发布前用一份清单校验实际文件
构建号回答“是哪一版”,文件清单回答“这一版到底包含哪些文件”。
清单通常包含:文件路径、每个文件的哈希、文件总数。打包时生成,部署前用同一份清单核对目标目录:不能少文件,不能多文件,不能有文件内容不一致。
这一步能拦住很多“看起来发了、其实没发全”的问题:
- 本地新增的模板文件没有进包,线上报错;
- 构建产物是旧的,源码已经改了;
- 部署目录里残留了上一次的旧文件,和新版本混在一起。
清单不需要复杂工具,一个脚本遍历目录、计算哈希、输出 JSON 就够。关键是两点:清单必须和这次构建绑定,部署时必须真的核对,而不是生成完放在那里。
四、发布门禁:业务回归和安全回归分开做
有了构建号和清单,还需要回答“这一版能不能上”。建议分成两道门禁:
业务门禁验证用户路径:首页、列表、详情、登录、发布草稿、搜索、分页、软导航返回、移动端布局。它回答“核心功能还正常吗”。
安全门禁验证边界:未登录能做什么、别人的草稿能不能读、私有文件是否只对本人可见、上传是否校验类型、跨站请求是否被拒。它回答“有没有把不该开的口子打开”。
两道门禁都应该绑定同一个构建号和同一份清单,并记录完成时间。门禁报告如果对不上当前构建,就不能作为这次发布的依据——改一个文件、重新构建后,旧报告立即失效,必须重跑。
门禁不一定要很重。一个小项目至少保留:匿名访问核心页面、登录后读写自己的内容、越权访问被拒这三类用例。等出现真实事故,再按事故类型补用例。
五、发布必须带恢复点,代码和数据分开处理
发布前先备份,这句话听起来是老生常谈,但真正要命的是备份的内容和恢复方式。
代码和数据库要分开看:
- 代码可以重新构建,恢复点主要保留当时的配置与文件快照;
- 数据库包含用户真实写入,不能用“重新部署一次”代替恢复;
- 上传文件、私有媒体往往不在数据库里,需要单独备份。
恢复点要写清楚:备份了什么、放在哪、怎么校验、谁能读取。备份文件本身也要做完整性校验,否则需要恢复时才发现备份是坏的。
还有一个容易混淆的点:测试环境和生产环境的数据库不是一回事。发布生产时,不要把测试库导入生产;测试数据可以用来验收,但不能变成生产内容。
六、发布后验收:用真实浏览器和构建号确认
发布脚本跑完不等于完成。至少做三件事:
- 看响应头或构建文件,确认线上构建号等于本次发布号;
- 用真实浏览器走一遍关键页面,桌面和手机各看一次;
- 检查健康状态:核心接口、登录、搜索、上传是否正常,错误日志有没有新增异常。
验收要记录身份和操作。匿名访问能通过的页面,不代表登录用户也正常;反过来,管理员能看到的页面,不代表普通成员能打开。
如果验收发现问题,先判断影响范围:是显示问题、功能问题,还是数据问题。显示和功能问题可以回滚代码;数据问题要先停止相关写入,再按恢复点处理,避免用旧数据覆盖新写入。
七、一个虚构的发布记录示例
下面是一段虚构记录,只演示字段,不对应任何真实项目:
构建:a1b2c3d4e5f6(由源码哈希生成)
清单:210 个文件,缺失 0,变更 0,多余 0
业务门禁:24 项通过,0 失败
安全门禁:15 项通过,0 失败
恢复点:数据库、配置、上传文件、私有媒体已备份并校验
发布:维护模式下替换代码,迁移完成,冒烟 35 项通过
验收:匿名桌面/手机核心页面通过,响应头构建号一致
结论:发布完成;未验证项:真实支付回调(本期未涉及)
注意最后一行。把“没验证什么”写出来,比只写“全部通过”更有用。下一次发布或排查问题时,这些未验证项就是优先检查的对象。
八、常见误区
- 把一次成功当成稳定:同一份代码在不同机器、不同网络下表现可能不同,发布记录要能区分“通过”和“没测”。
- 门禁与构建脱钩:改了代码还沿用旧门禁报告,等于没做门禁。
- 只备份数据库:上传文件、配置、私有媒体丢失时,数据库完整也恢复不了页面。
- 用测试库覆盖生产:测试内容会混进真实站点,用户数据也会丢。
- 发布后不看日志:错误可能不影响首页,但会影响某个入口;发布后观察一段时间比事后补救便宜。

九、一页清单
发布前:
- ☐ 构建号由源码生成,能从提交复现
- ☐ 文件清单与本次构建绑定,部署前核对
- ☐ 业务门禁、安全门禁都在当前构建上通过
- ☐ 恢复点覆盖数据库、配置、上传文件、私有媒体,并校验通过
- ☐ 明确本次不涉及或未验证的范围
发布后:
- ☐ 线上构建号与发布号一致
- ☐ 匿名与登录身份的关键路径都走过
- ☐ 健康检查与错误日志无新增异常
- ☐ 发布记录写清结论和未验证项
可复现不是大团队的专利。哪怕只有一个人、一个周末项目,只要每次发布都能回答“哪一版、包含什么、怎么退回去”,AI 写得再快,也不会把项目带进无法收拾的状态。
相关阅读:发布前逐项检查可以看《AI 写的代码怎么上线?发布前必查的 6 项》;记录方式可以参考《构建记录怎么写?一份能直接套用的四段式模板》;为什么记录比代码更容易被忽略,见《为什么你的 AI 项目做完就废了》。
社区讨论 加载中…