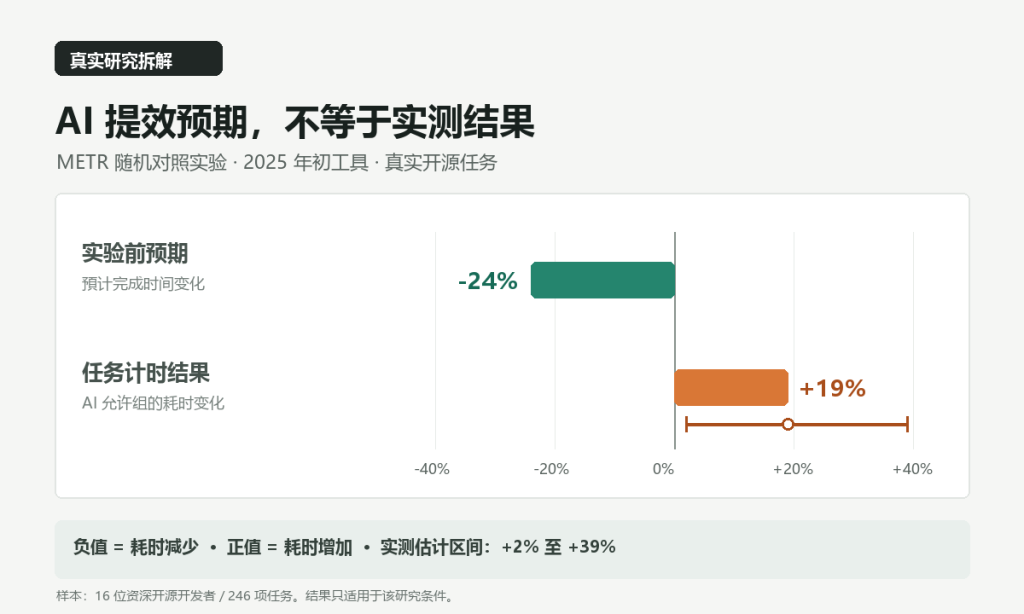
AI 编程工具是否提效,不能只看生成代码有多快。任务完成时间、返工、验收质量和任务类型都要一起看。METR 在 2025 年对 16 位资深开源开发者的 246 项真实任务做了随机对照实验:在这组任务和当时的工具条件下,允许使用 AI 的任务平均完成时间反而增加了 19%。这不是“AI 一定让人变慢”的结论,而是一个提醒:体感、演示和实际交付速度可能不是一回事。
METR 实验测了什么
参与者是长期维护大型开源项目的开发者。他们平均已经在自己的项目中贡献约五年,项目平均超过 2.2 万个 GitHub 星标、代码规模超过 100 万行。开发者提交平时确实会做的缺陷修复、功能和重构任务,再由研究人员随机决定每项任务允许或不允许使用 AI。任务平均约两小时,研究共纳入 246 项。
允许使用 AI 时,参与者主要使用当时的 Cursor Pro 与 Claude 3.5/3.7 Sonnet。这个细节很重要:研究测的是早期 2025 年工具在熟悉的大型代码库中完成真实 issue 的效果,不是今天所有模型、所有工作流、所有开发者的综合排名。
预期和计时结果相反
实验开始前,参与者预计 AI 会让完成时间减少 24%。完成实验后,他们仍估计 AI 让自己快了约 20%。但研究按任务完成时间估算,AI 允许组平均多花了 19%;METR 给出的区间为多花 2% 至 39%。因此,最值得注意的不是单独的一个百分比,而是主观感觉和任务计时出现了明显落差。

图注:原创数据图,根据 METR 2025 年研究的公开结果绘制。负值表示耗时减少,正值表示耗时增加;误差范围是研究报告的估计区间,不代表每位开发者的个人结果。
为什么不能把 19% 当成通用答案
首先,样本聚焦于有多年项目经验的开源维护者和成熟代码库。熟悉架构的开发者本来就能快速定位问题;AI 建议如果偏离项目约定,核对和修正会占去时间。新手、一次性脚本、从零搭建项目,面对的成本和收益都可能不同。
其次,这个实验使用的是 2025 年初的工具。METR 在 2026 年 2 月回顾后续实验时指出,后续数据受到明显的选择偏差影响:不愿在没有 AI 的情况下工作的开发者更可能不参加,开发者也会回避不想在无 AI 条件下做的任务;同时,多智能体并行场景的耗时记录不够可靠。METR 因此明确表示,这批后续数据不能可靠估计当时 AI 的真实生产力影响。它提示工具可能进步了,却不能提供可信的统一提速比例。
最后,完成时间不是全部价值。AI 可能帮助开发者处理原本不会做的任务,也可能增加审查、测试和后续维护工作。若只记录“第一版代码出来用了几分钟”,就会漏掉最终交付真正需要的成本。
先把“提效”拆成可观察的结果
谈效率时,至少要分清三个问题:同一项任务是否更快完成、同一段时间能否交付更多合格任务、以及是否能尝试过去做不起的任务。METR 的计时结果主要回答第一项,不能单独说明另外两项。对维护工作来说,少花半小时却留下难审查的补丁,未必是净收益;若 AI 让原本不敢接手的测试覆盖得以补齐,也不能只用单个 issue 的耗时衡量价值。
因此,团队评估前应先约定“完成”的终点:代码通过哪些测试、是否需要评审通过、文档和迁移是否算在内。条件变了,就把任务记为另一组,不要把更快的初稿和已经验收的交付放在同一列比较。最终需要的是适用于当前项目的证据,而不是把某篇研究的平均值当作自己的目标。
个人怎么测 AI 编程有没有省时间
不用先设计大型研究,但要把比较条件说清楚。可以挑一组相近、可验收的任务,记录每项任务的代码库、任务类型、使用的工具和日期,并尽量交替安排 AI 与非 AI 条件。不要只比较一个顺手的小任务和一个陌生的大需求。
任务描述也要先写清楚输入、范围和验收条件。可以参考这份AI 编程需求写法示例,再将相近任务分成一组比较。若无法随机分配,至少记录分组原因;否则,AI 组恰好拿到简单任务时,结果会显得更好。
每个任务至少记录四项:
- 总耗时:从开始调查到通过验收,包括阅读 AI 输出、修正、测试和等待;并发处理其他事情时,单独标出无法准确归属的时间。
- 结果质量:按事先写好的标准检查功能、边界输入、测试和项目约定,不要在看到结果后临时降低标准。
- 返工情况:记录被拒绝的建议、回滚、额外修改和后续缺陷。代码行数或生成速度不能代替返工成本。
- 适用任务:区分补测试、查陌生模块、批量机械改动和架构决策,分别看结果,不要把差异很大的任务压成一个平均数。
小样本只能帮助团队找到值得继续验证的任务类型,不能证明 AI 对所有项目都提效。若任务差异很大、验收口径在中途变化,结果应标为不可比,而不是硬算出一个漂亮比例。
把结论写成可复查的构建记录
一条有用的结论应当能回答:在什么任务和代码库中,使用了什么版本的工具,计入了哪些时间,结果如何验收,哪些情况还没测。可以用问题、工具、结果、下一步四段式留下记录;之后模型或项目条件变化,再用相同口径复测。
记录可以沿用四段式构建记录模板,并参考AI 任务复现清单保存输入和验收条件。若要把自己的测量过程分享给其他创作者,可以在广场的“方法与工具”分类发布记录;没有实际执行过的结论应标明范围,不要写成验证通过。也可以从发布页整理成可复查的构建记录。
所以,METR 这项真实实验更适合被读成一个测量案例:AI 提效不是一个脱离任务的常数。看完成交付所需的总时间和质量,再按任务类型决定是否采用,远比用生成速度或个人体感下结论可靠。
社区讨论 加载中…