AI 输出不稳定,几乎都能归到下面五处没固定:输入、参数、版本、步骤、验收。你只改了其中一处,结果当然不可比。
这不是模型"抽风"。生成式模型每次都在重新采样,除非你主动把变量按住,否则它每次都在做一道新题。区别只在于:有些变化你能接受,有些不能。
先分清哪种「不一样」可以接受
不是所有差异都叫不稳定。先划一条线:
- 可以接受:措辞变了、同义表达换了、段落顺序微调,信息没丢。
- 不可以接受:字段少了、结论反了、数字错了、结构散了。
这条线要在跑之前划好,不是跑完再判断。跑完再判断,人会不自觉地把这次的结果解释成"也行"。
判断标准很简单:把这次输出交给一个不知情的人,他能不能完成你原本要做的事。能,就是可接受;不能,就是不可复现。
固定项一:输入
同一段提示词,输入换一版,结果就没有可比性。
要固定的是:原始素材本身(同一份文件、同一张图,不是"差不多的另一张")、素材的尺寸与裁切、以及你贴进对话的上下文长度。长文档被截断这件事很常见,前五千字和后五千字是两个任务。
一个容易被忽略的点:图片的压缩。同一张图重新导出一次,尺寸和压缩率变了,生成结果的细节也会跟着变。
怎么做:把输入单独存一个文件夹,命名带版本号,例如 input-v1。跑之前确认这次用的还是它。换输入就等于换题,之前的结论全部作废。
固定项二:参数
文本生成里最常调的是 temperature 和 top_p,图像、视频生成里最常调的是随机种子(seed)和画面尺寸。它们的作用方向不同:
- temperature / top_p:控制随机性。调低,输出更收敛、更重复;调高,更发散、更容易跑偏。具体取值范围以官方文档为准。
- seed:固定"这一次"的随机起点。同样输入、同样模型版本下,同 seed 的结果应当接近。
- 尺寸 / 比例:会改变构图。同一提示词,横图和竖图不是同一张画。
判断标准:如果你说不出这次改了哪个参数,那这次结果就不能拿来和上一次比。
顺带一句:seed 不是万能的。服务端换了硬件、模型做了小版本更新,同 seed 也可能变。它能减少波动,不能承诺逐像素一致。
固定项三:版本
模型名称要带版本,不要只写"最新版"。依赖也要锁版本。
这件事在代码类任务上尤其明显:同一个提示词,换一个模型版本,代码风格和出错方式都会变。今天跑通的方案,下周不一定还能跑。
判断标准:三个月后,你能不能照着记录把环境还原出来。还原不出来,这条经验就不能交给别人用。
版本升级之后,把内容状态改成「需要重新验证」。四段式构建记录里把这套状态写得很清楚:这不是退步,是准确。
固定项四:步骤
一次只改一个变量。这是实验设计里最老的一句话,也是最常被违反的一句。
常见场景:结果不对,于是同时改了提示词、换了模型、加了两个例子。结果变好了,但你不知道是哪一处起了作用。下次再出问题,还是从零开始猜。
另外两件事:
- 保留中间产物。每一步的输出都存下来,不要只留最后一版。
- 同一任务跑三遍再下结论。跑一遍就宣布"稳定",等于没测。
判断标准:你能不能指出"是这一步让它变好的"。指不出来,就是没控制变量。
固定项五:验收
先写验收标准,再跑。顺序反过来,人就会围着结果找理由。
把"看起来不错"换成能勾选的条目。比如整理会议记录这个任务,验收项不是"总结得挺好",而是:
- 每条待办都有负责人
- 每条待办都有截止时间,没有的标"未定"
- 每条待办能追到原文第几行
- 没有把讨论中的假设写成已决定事项
四条全过才算通过。过不了,先改验收项对应的那一段提示词,不要整段重写。
一张能直接抄的固定项清单
对照表(主题暂不渲染 Markdown 表格,改成列表):
- 输入:素材文件名与版本、尺寸、上下文长度 — 换人拿这份输入,能得到同一道题
- 参数:temperature / top_p / seed / 尺寸 — 能说出这次改了哪一个
- 版本:模型名带版本号、依赖锁版本 — 三个月后能还原环境
- 步骤:每次只改一个变量、保留中间产物 — 能指出是哪一步起的作用
- 验收:可勾选的条目,不是形容词 — 四条里过了几条,一眼能看到
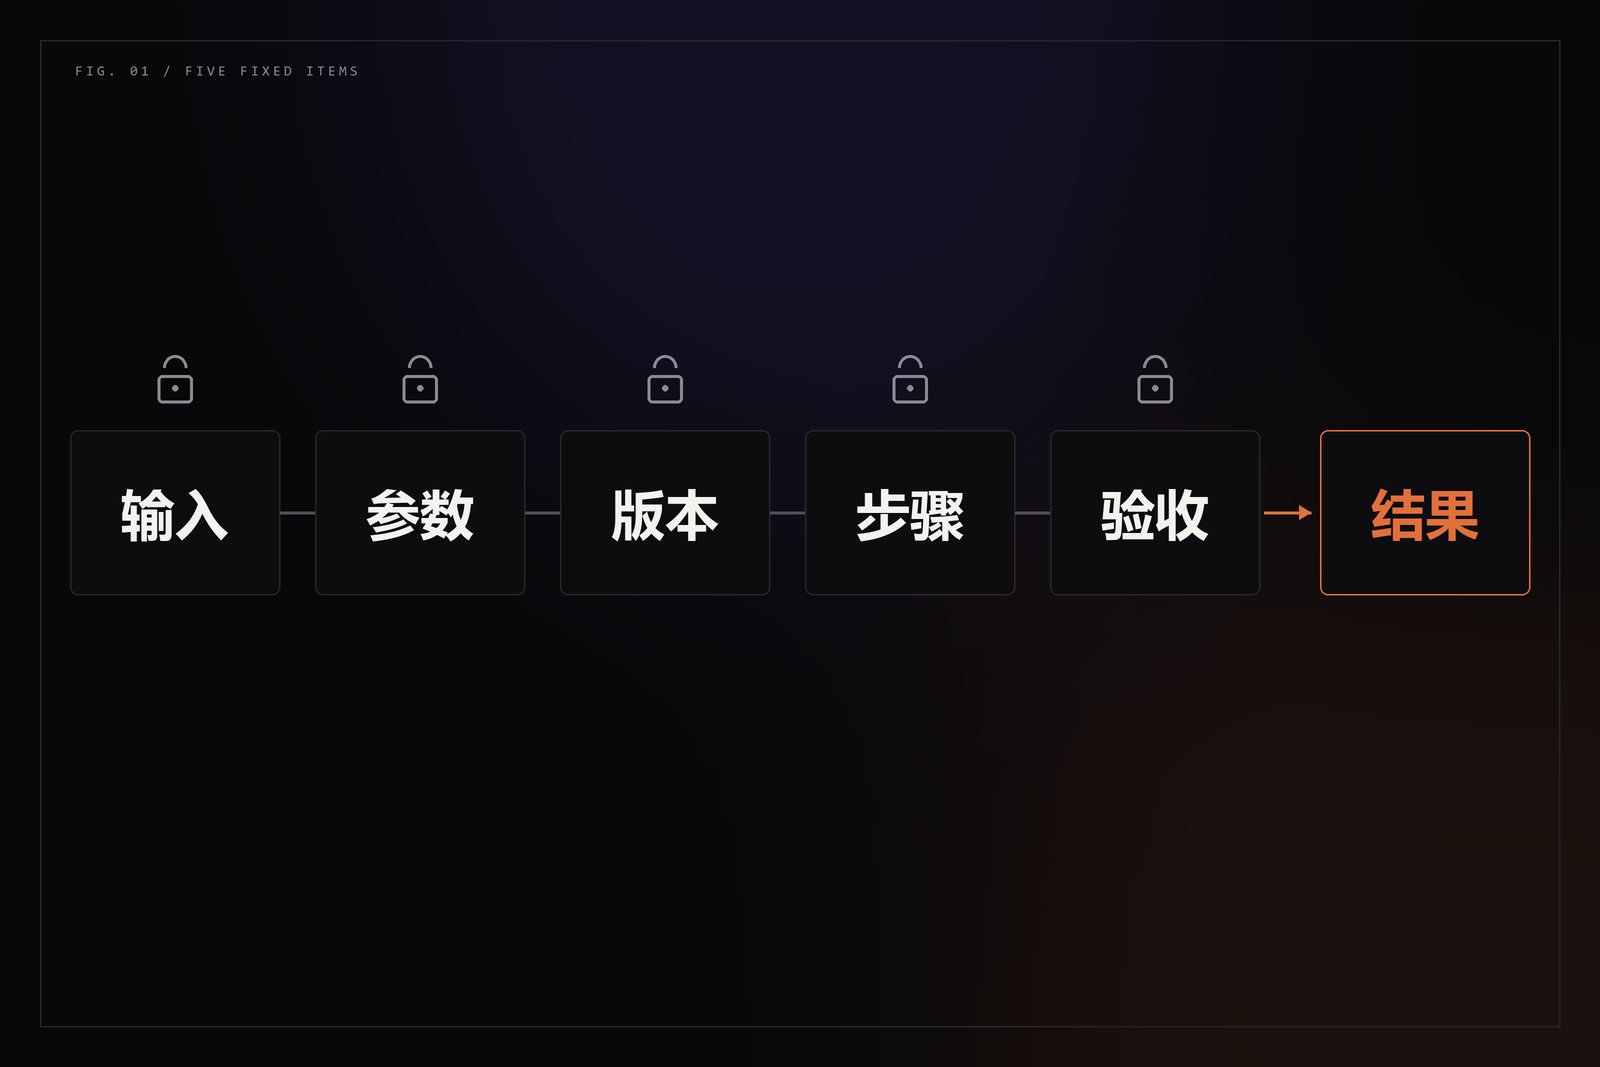
这张表不用填满才开始。先填输入和验收两项,稳定性就会明显不一样。
案例:把 30 行会议记录整理成待办表
下面这个案例可以当场照做。它的重点不是"AI 能不能整理会议记录",而是"怎么让这件事每次都对"。
第 0 步:先把输入固定下来。 准备一份 30 行左右的会议记录,存成 meeting-v1.txt。不要用聊天窗口里边聊边改的版本,那已经不是同一份输入了。
第 1 步:写验收项。 四条:负责人、事项、截止时间、来源行号。缺一项就算不通过。
第 2 步:把输出结构写进提示词。 不要写"整理成待办",要写清楚字段和缺省规则:
把下面的会议记录整理成待办表,只输出表格,不要解释。
字段:负责人 / 事项 / 截止时间 / 来源行号。
规则:
1. 负责人没提到就写"未指定",不要猜。
2. 截止时间没提到就写"未定",不要补。
3. 来源行号写原文的行号,不要写段落大意。
4. 一条待办只对应一件事,不要把两件事合并。
第 3 步:固定模型和参数。 记下模型名和版本,temperature 调到你认为最稳的那一档,写进记录。之后不要随手换。
第 4 步:跑第一遍。 把 meeting-v1.txt 全文贴进去,不要截取。跑完先不看内容,先数四条验收项过了几条。
第 5 步:只改一处。 如果"截止时间"这一列大量是"未定",先回去看原文里到底有没有写时间。原文有、输出没有,是提示词的问题;原文没有、输出编了一个,是约束不够。这两种情况的改法完全相反。
第 6 步:跑第二遍和第三遍。 同样的输入、同样的提示词、同样的参数。三遍都过,才算稳定;有一遍不过,回到固定项表里逐项排查,不要重写整段提示词。
第 7 步:记录。 把输入文件名、提示词原文、模型版本、参数、三遍的验收结果写进构建记录。这一步比结果本身有用——下次换一份会议记录,你可以直接复用这套设置。
一个提醒:不要用"这次总结得比上次好"作为判断。好是感受,过没过是事实。
什么情况下不必追求复现
复现有成本。下面三种情况,强行固定反而是浪费:
- 一次性任务:跑完就删的脚本、只看一次的会议纪要,不需要建固定项表。
- 探索阶段:你在试哪种风格可行,这时候需要的是发散,不是收敛。先把范围打开,再固定。
- 创意类产出:文案的多种写法、构图的多个方案,本来就该有差异。这时候要固定的是"不能出现什么",不是"必须长成什么样"。
判断标准:这件事会不会做第二次、要不要交给别人做。两个答案都是"否",就不用建表。
把结果留下来
固定项表填完,只是你自己知道。要让别人也能复现,得把它写下来。
四段式构建记录里的四段式够用:问题、工具、结果、下一步,再把固定项表作为附件贴上去。发到发布页时,验证状态按实际情况选——只有你真的按这套条件跑过三遍,才选「作者已验证」。
一个常见的偷懒:把"跑通了"当成"验证过了"。跑通只说明主路径能走,验证要说明边界在哪、哪一段还不稳。
如果你只记一件事,记这个:可复现不是把提示词存下来,是把当时的所有条件存下来。 提示词只是其中一项。
社区讨论 加载中…