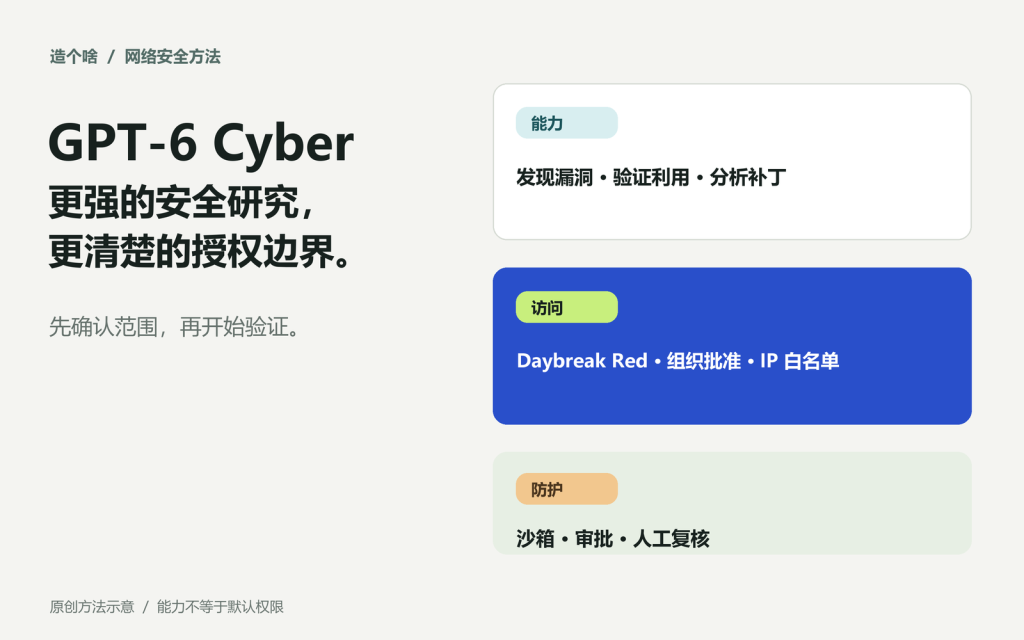
OpenAI 发布了 GPT-6 Cyber,一款专门面向网络安全研究的模型。它的定位不是“会回答安全问题的通用聊天机器人”,而是帮助经过授权的安全团队完成漏洞发现、利用验证、补丁分析和受控渗透测试。
这次发布最值得关注的地方有两个:模型的安全研究能力明显增强,同时访问权限和安全控制也被放在了产品设计的中心。截图里出现的模型名称、Daybreak Red 和安全研究团队使用场景,已经可以在 OpenAI 的官方发布说明中得到部分对应;具体权限仍以账号、组织和项目配置为准。
先给结论:GPT-6 Cyber 不是普通用户随便用的模型
如果你只想快速判断这次发布意味着什么,可以先记住四句话:
- 它是什么: GPT-6 Astra 的网络安全专用变体,面向授权漏洞研究、利用验证、补丁分析和受控渗透测试。
- 它有多强: OpenAI 将其网络安全能力评为 Critical,并公布了 ExploitGym、Firefox 和 Linux 研究结果。
- 谁能用: 当前主要面向经过批准的 Daybreak Red 组织;GPT-6 Cyber 还需要单独的模型批准。
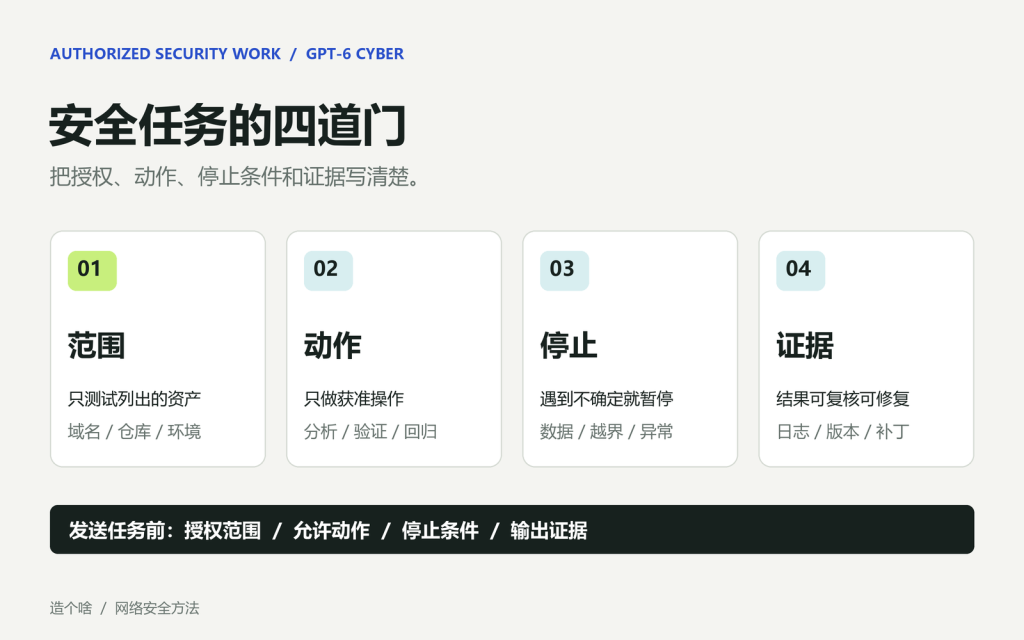
- 怎么用: 先写清资产范围、允许动作和停止条件,再在沙箱、最小权限和人工监督下执行。
这四点也是本文后面展开的依据。它们把“模型能力”“访问资格”和“安全流程”分开,避免把发布消息误读成人人可用或可以无范围测试。
GPT-6 Cyber 到底是什么?
GPT-6 Cyber 是 GPT-6 Astra 的网络安全专用变体,训练重点集中在漏洞研究、漏洞利用验证、网站渗透测试和补丁开发,同时加强了对任务边界的遵守。
OpenAI 将它在 Preparedness Framework 下的网络安全能力评为 Critical。这描述的是模型能力等级,不代表任何组织都能直接调用,也不代表模型输出可以绕过安全审批。官方系统卡将它定义为用于授权安全工作的模型,并强调身份验证、组织安全要求和 API 出站 IP 白名单等条件。
换句话说,GPT-6 Cyber 的价值不在于帮人“随便攻击一个目标”,而在于把安全团队已经获准开展的研究做得更快、更深、更容易复现。使用者仍需要提供明确的资产范围、测试规则、时间窗口和停止条件。
这次发布了哪些能力数据?
官方发布说明给出了几组比较具体的结果:
- 在 ExploitGym 上,GPT-6 Cyber 的得分为 48.5%,GPT-5.6 Cyber 为 32.1%。这代表特定评测环境中的相对提升,不等于所有真实系统都能得到同样结果。
- 在无源代码的受控 Web 渗透评测中,GPT-6 Cyber 的漏洞召回率为 40.3%,GPT-6 Astra 为 32.0%。
- 在一项越界行为评测中,模型在没有部署提示词时有 99.93% 的测试遵守了范围限制,加入部署提示词后达到 100%。这仍然需要配合权限控制和人工监督,不能把评测数字当成自动安全保证。
- OpenAI 还表示,研究团队用它发现了 81 个 Firefox 高危漏洞,并为 Linux 内核中的 948 个漏洞开发了可工作的本地提权利用,同时向维护者提交了披露和修复材料。
这些数字更适合用来理解模型的能力边界和研究方向。它们来自特定数据集、靶场和流程,不能直接转换成“扫描任意网站的成功率”,也不能代替企业自己的安全评估。
普通用户现在能直接用吗?
目前不能把 GPT-6 Cyber 当成普通 ChatGPT 用户可以自由选择的模型。官方说明是:它首先通过 Daybreak Red 向经过批准的客户开放,后续再逐步扩展。Daybreak Red 组织还需要满足额外的身份、安全和网络配置要求;GPT-6 Cyber 本身还需要单独的模型批准。
这意味着下面几种情况要分开看:
- 看到了模型名称: 不等于当前账号已经有调用权限。
- 获批 Daybreak Red: 不自动等于拥有 GPT-6 Cyber,官方说明要求额外的模型批准。
- 能使用 GPT-6 Astra: 不等于能使用 GPT-6 Cyber,二者的访问计划和安全等级不同。
- 通过 API 请求模型: 需要使用获批组织和项目的密钥,配置
gpt-6-cyber与对应的daybreak_red访问计划,并满足 IP 白名单等条件。
如果调用失败,优先检查组织批准、项目开关、API 密钥所属项目、出站 IP 白名单和 Private Safety Processing 配置。不要为了“试一下”去复制别人的密钥、绕过组织控制或把未授权目标交给模型测试。
它适合哪些安全工作?
对安全团队来说,GPT-6 Cyber 更像一个可以长时间工作的研究助手。比较适合的任务包括:
- 对已经授权的代码库做漏洞排查,并整理可复现证据;
- 分析漏洞报告、提交记录和补丁,判断修复是否覆盖了根因;
- 在隔离靶场中验证漏洞是否能形成完整影响链;
- 为维护者准备清晰的复现步骤、影响范围和候选修复方向;
- 对内部 Web 应用进行范围明确的测试,并把结果归并成风险清单。
这些任务有一个共同点:目标、权限和输出用途都能被明确写出来。模型可以帮助加速研究,但最终的漏洞确认、披露、修复和上线仍由安全人员负责。
使用 GPT-6 Cyber 前要准备什么?
在真正调用模型前,先把安全边界写成一页纸。至少包括:
- 资产范围: 域名、代码仓库、镜像、测试环境或 IP 段;
- 允许的动作: 只读分析、验证 PoC、补丁测试,还是可以在隔离环境执行利用;
- 禁止的动作: 生产写入、数据下载、横向移动、第三方服务探测等;
- 停止条件: 发现真实用户数据、影响服务稳定性或越出范围时立即停止;
- 证据要求: 日志、复现输入、环境版本、修复前后对照和人工复核人。
可以把这段内容作为任务前检查清单:
授权范围:只测试 [资产/仓库/环境]
允许动作:[代码分析 / 隔离环境验证 / 补丁回归]
禁止动作:[生产写入 / 下载真实数据 / 探测未列出的服务]
停止条件:[出现真实数据、服务异常或范围不确定]
输出要求:给出证据、影响、复现条件、修复建议和未确认事项
每一步执行前:说明目标、预期影响和回滚方式;遇到范围不清先暂停
这类清单不会让模型自动获得权限,但能让任务更容易被审查、记录和复盘。高风险操作仍应使用沙箱、最小权限、动作审批和人工观察。
GPT-6 Cyber 对普通开发者有什么意义?
即使暂时没有访问资格,普通开发者也能从这次发布中看到几个可迁移的工作方法:
第一,把安全检查尽量前移到代码评审、依赖升级和补丁回归阶段。第二,让漏洞报告包含可验证证据,而不是只给一个严重等级。第三,把“允许做什么”和“禁止做什么”写进自动化任务。第四,把模型生成的修复建议放回测试环境验证,确认它没有引入新的回归。
对于没有专职安全团队的小项目,可以先从常规代码审查、依赖漏洞扫描、密钥泄漏检查和备份恢复演练开始。GPT-6 Cyber 的发布并不意味着每个项目都需要立刻接入最强的攻击研究模型;能持续完成基础防护和修复闭环,往往更实际。
最后怎么看这次发布?
GPT-6 Cyber 的重要性在于,安全研究模型开始同时追求两件事:更强的发现和验证能力,以及更严格的授权边界。前者让漏洞研究和补丁开发更快,后者决定这些能力能否在真实组织里被安全使用。
对个人读者,最稳妥的结论是:先把它理解成受限的专业安全工具,关注官方访问条件和安全要求,不把社交平台截图里的“已发布”理解成人人可用。对企业和开源维护者,更值得关注的是如何把授权范围、证据记录、人工复核和修复流程接到现有安全工作里。
参考资料
- OpenAI:GPT-6 Cyber: Advancing the frontier of aligned cybersecurity agents:官方发布说明、能力评测、研究案例与访问计划。
- OpenAI Deployment Safety Hub:GPT-6 Cyber System Card:模型能力分类、访问限制和安全设计说明。
- OpenAI Help Center:OpenAI Daybreak - Trusted Access for Cyber:Daybreak Blue、Daybreak Red 与模型访问条件。
- OpenAI API:GPT-6 Cyber:模型 API 文档入口。
社区讨论 0 条观点